
Más allá de la IA integrada: Optimización de la canalización de percepción térmica desde los datos del sensor hasta la implementación en el borde
RESUMEN
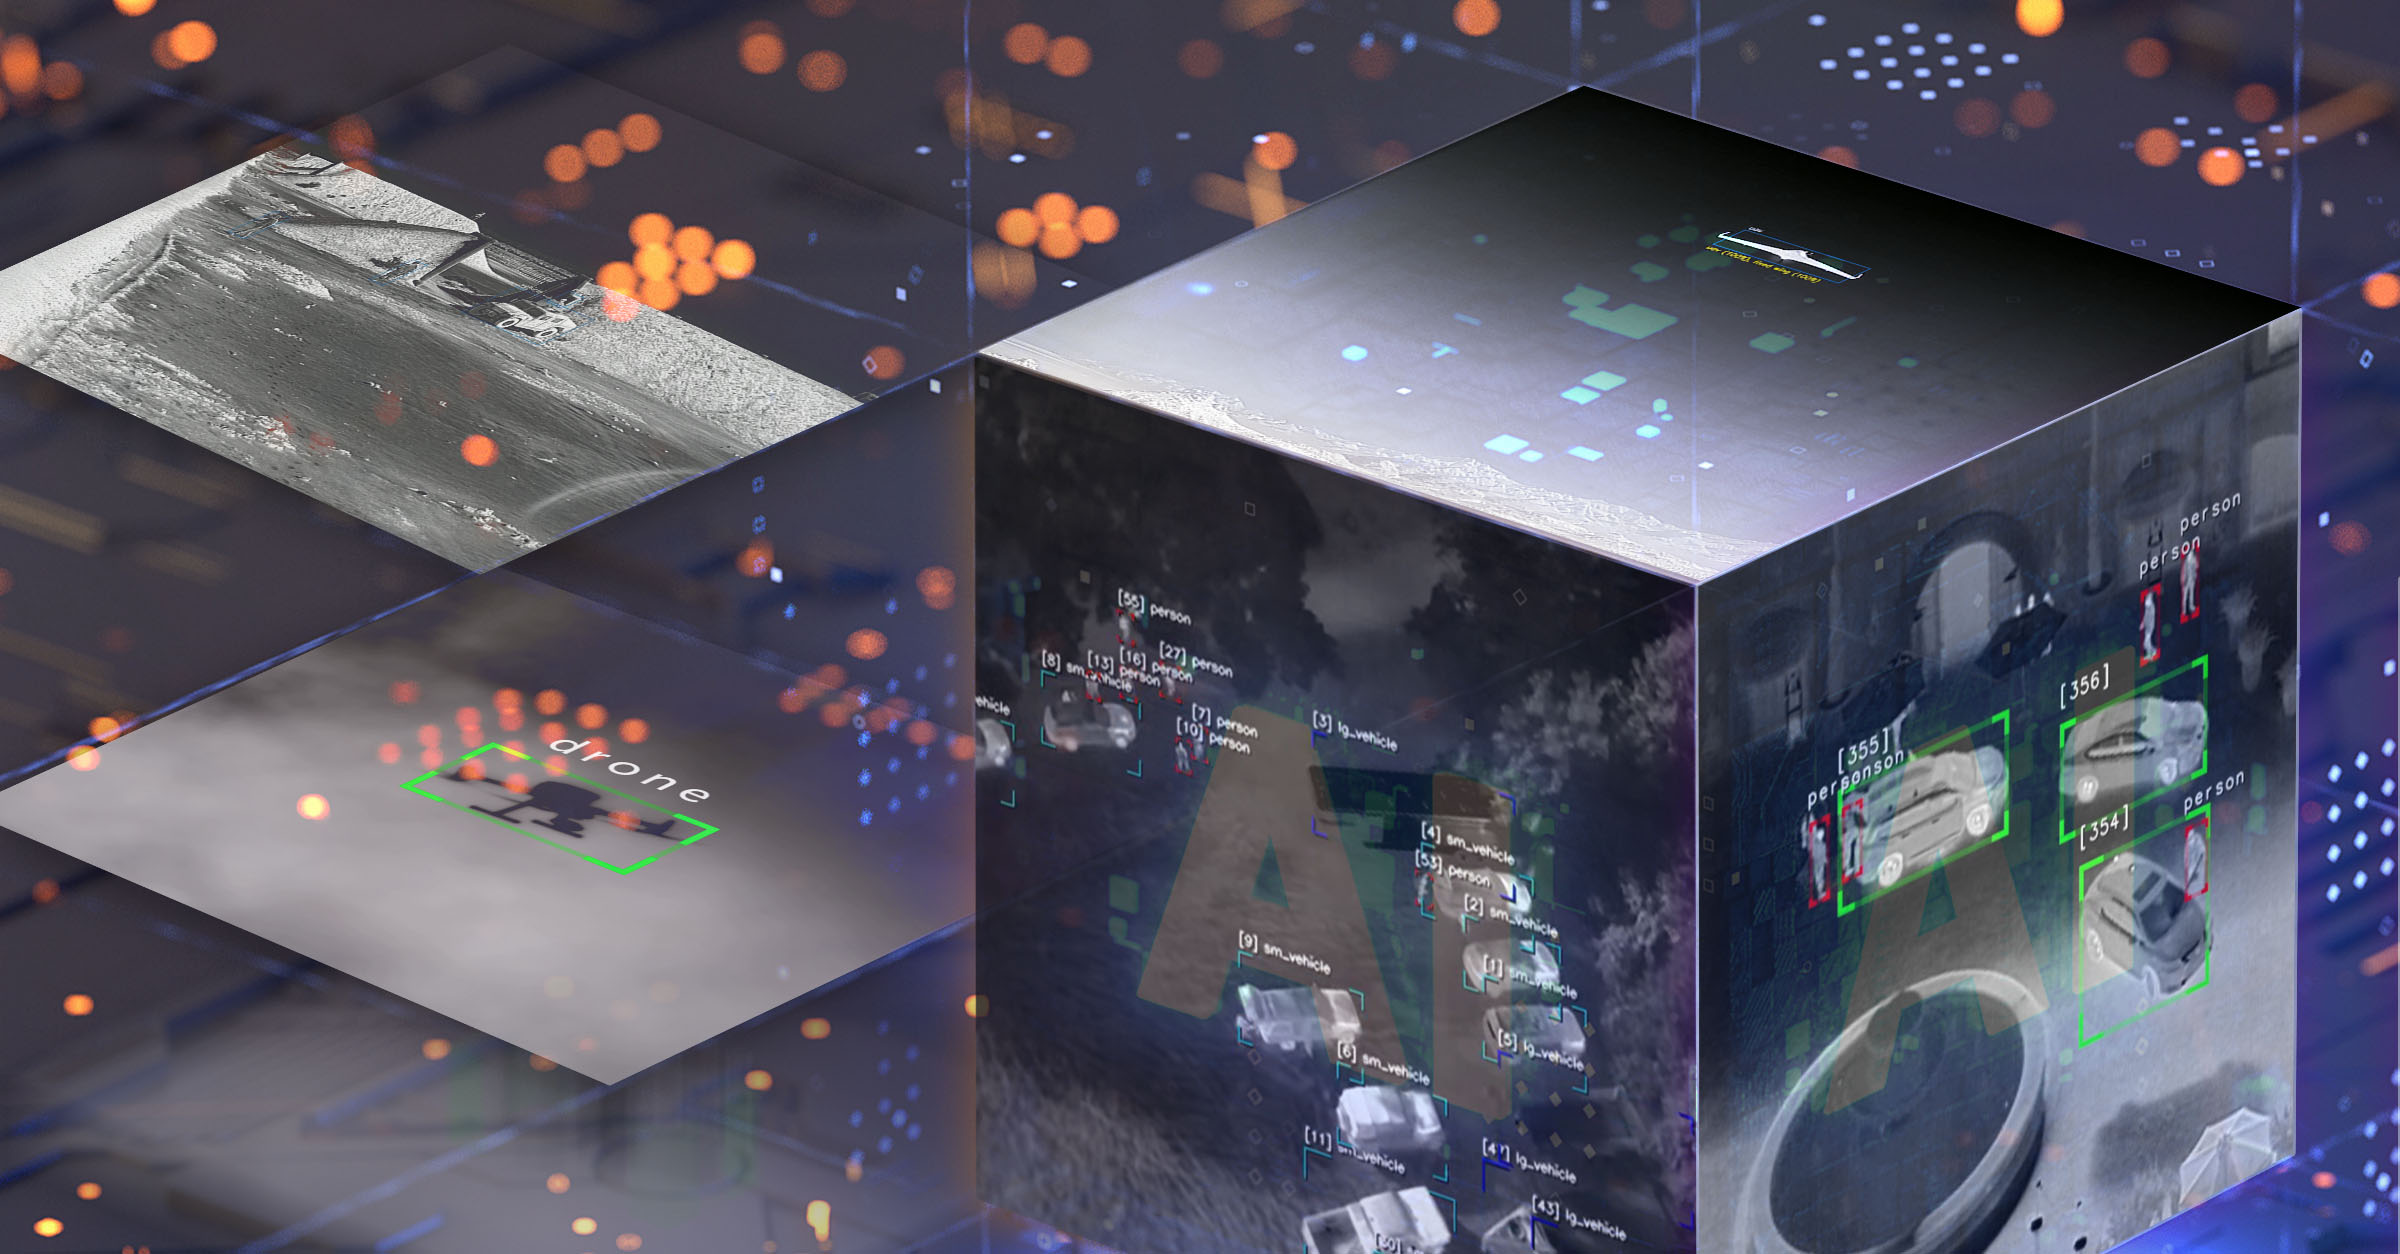
Los rápidos avances en aprendizaje profundo, imágenes computacionales y procesadores integrados han hecho posible ejecutar cargas de trabajo de percepción sofisticadas en el borde. Para sistemas térmicos y multiespectrales, la ventaja competitiva va más allá de colocar un modelo de inteligencia artificial (IA) en un procesador integrado. La mayor ventaja proviene de optimizar la canalización de percepción completa, desde el procesamiento de datos de sensores y señales de imagen hasta la detección de objetos, el seguimiento, la optimización del tiempo de ejecución, la gestión térmica y la implementación en campo, bajo limitaciones del mundo real en cuanto a tamaño, peso, potencia, latencia, ancho de banda y condiciones ambientales.
Este documento describe cómo Teledyne FLIR OEM integra el procesamiento de señales de imágenes térmicas y multiespectrales Prism™, bibliotecas de detección y seguimiento específicas de aplicaciones y plataformas modernas de IA integradas para ayudar a los clientes a crear sistemas de imágenes inteligentes que proporcionen información procesable en el punto de detección.
.
ÍNDICE
- Acrónimos
- Introducción
- Avances en modelos ligeros y procesadores móviles
- Diseño de una red neuronal para plataformas integradas - Presentación de PeleeTM
- Optimización
- La potencia de desarrollo rápido de los procesadores móviles
- Marcos
- Tubería de procesamiento de vídeo
- Funciones Prism ISP
- Conclusiones
1. Acrilones
| Acrónimo | Definición |
|---|---|
| ADAS | Sistemas avanzados de asistencia al conductor |
| AGC | Control de ganancia automático |
| IA | Inteligencia artificial |
| ARM | Arquitectura avanzada de procesador de máquina RISC |
| ASIC | Circuito integrado específico de la aplicación |
| ATR | Reconocimiento automático de objetivos |
| CI | Imágenes computacionales |
| CNN | Red neuronal convolucional |
| CPU | Central Processing Unit (Unidad de Procesamiento Central) |
| DSP | Procesador de señales digital |
| FFB | Bloque de fusión de funciones |
| FPGA | Matriz de puertas programable sobre el terreno |
| GPU | Unidad de procesamiento de gráficos |
| HTP | Procesador Tensor Hexagon |
| ILSVRC | Desafío de reconocimiento visual a gran escala ImageNet |
| INT | Formato de precisión entero, como en INT8 o INT4 |
| secuencia | Propiedad intelectual |
| IR | Infrarrojos |
| ISR | Inteligencia, vigilancia y reconocimiento |
| ISP | Procesamiento de señales de imagen/Procesador de señales de imagen |
| LCE | Mejora del contraste local |
| MSX | Imagen dinámica multiespectral |
| NMS | Supresión no máxima |
| NPU | Unidad de procesamiento neural |
| ONNX | Intercambio abierto de red neuronal |
| PANet | Red piramidal de características de agregación de rutas |
| RAM | Memoria de Acceso Aleatorio |
| RISC | Ordenador con juego de instrucciones reducido |
| SDK | Software Development Kit (Kit de Desarrollo de Software) |
| SLAM | Localización y mapeo simultáneos |
| SoC | Sistema en chip |
| SoM | Sistema en módulo |
| SSD | Detector de un solo disparo |
| SWaP | Tamaño, peso y potencia |
| TOPS | billones de operaciones por segundo |
| YOLO | Solo mira una vez |
2. Introducción
Durante la última década, los avances en el aprendizaje profundo han transformado la visión artificial de sistemas construidos en torno a la extracción de características artesanales en modelos basados en datos entrenados en grandes conjuntos de datos y optimizados para tareas de percepción especializadas. Este cambio cambió fundamentalmente los desafíos de la detección de objetos: en lugar de diseñar características visuales fijas a mano, los desarrolladores ahora se centran en recopilar datos de formación representativos, seleccionar arquitecturas de modelo adecuadas y adaptar redes neuronales cada vez más sofisticadas a condiciones de implementación del mundo real. Como suele suceder en el desarrollo temprano de la tecnología, inicialmente se prestó menos atención a la potencia informática necesaria para entrenar y ejecutar estos modelos.
Esta falta de preocupación limitó la forma en que se podría utilizar la nueva tecnología en sistemas basados en la visión, especialmente en aplicaciones centradas en vídeo, donde la necesidad de clasificación de objetos en tiempo real, generación de metadatos y alertas es fundamental. Al mismo tiempo, se estaba pagando una carrera de armas en la industria de los teléfonos móviles en torno al rendimiento de la cámara. Esto condujo al rápido desarrollo de procesadores de señales de imagen (ISP) altamente avanzados que permitieron un rendimiento de cámara cada vez mejor utilizando algoritmos y lo que ahora se conoce como imágenes computacionales (CI). Más recientemente, la rápida adopción de modelos de lenguaje grande, modelos de lenguaje de visión e IA multimodal ha aumentado la demanda de procesadores heterogéneos que puedan ejecutar tanto tuberías de visión tradicionales como cargas de trabajo más recientes inspiradas en modelos de base más cerca del sensor.
Los procesadores actuales cuentan con arquitecturas heterogéneas con varias unidades de procesamiento central (CPU), unidades de procesamiento gráfico (GPU), procesadores de señales digitales (DSP), unidades de procesamiento neural (NPU) y bloques de cálculo ISP. Además, la comunidad de código abierto ha aportado muchos de los componentes utilizados para crear sistemas de percepción, incluidos detectores de objetos de la familia YOLO, modelos de detección basados en transformadores, formatos de archivo independientes de la plataforma como Open Neural Network Exchange (ONNX), marcos de desarrollo como PyTorch y TensorFlow y tiempos de ejecución de producción como TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite y kits de desarrollo de software (SDK) específicos de hardware. Se ha convertido en un flujo de trabajo común para entrenar en PyTorch o TensorFlow, exportar a ONNX, optimizar y cuantificar para el tiempo de ejecución objetivo y luego validar la latencia, la potencia, el uso de memoria y la precisión directamente en el hardware implementado.
El OEM de Teledyne FLIR se centra en integrar la percepción y el procesamiento computacional de imágenes o señales de imagen en procesadores optimizados de alto tamaño, peso y potencia (SWaP) para una amplia gama de aplicaciones. Aprovechar los nuevos diseños de silicona fabricados en los nodos más avanzados permite a los desarrolladores de sistemas aumentar la duración de la batería y simplificar la gestión térmica del sistema.
Este es el desafío central del diseño para los sistemas térmicos inteligentes. Las técnicas de IA de cámara visible no se pueden transferir simplemente a la termografía sin tener en cuenta la física del sensor, el contenido de textura más baja, la variabilidad ambiental, los efectos atmosféricos, el tamaño del objetivo, la óptica, la velocidad de fotogramas, la calibración y los pasos de procesamiento de imágenes que dan forma a lo que ve el detector. En la práctica, el rendimiento de detección y seguimiento depende de toda la cadena: datos de sensores sin procesar, procesamiento radiométrico o no radiométrico, mapeo de tonos, eliminación de ruido, estabilización, superresolución, arquitectura de modelos, cuantificación, mapeo de tiempo de ejecución, ancho de banda de memoria y gestión de energía. La ventaja de Teledyne FLIR OEM radica en su capacidad de optimizar en toda esa cadena en lugar de tratar la inferencia de IA como una función independiente.
3. Avances en modelos ligeros
y procesadores móviles
Una vez que se reconoció el impacto del aprendizaje profundo en la visión artificial, comenzó el trabajo en el desarrollo de redes y modelos neurales que podían ejecutarse en el borde en procesadores móviles de bajo coste, lo que permitió la detección de objetos para aplicaciones de vídeo en tiempo real, incluido el reconocimiento automático de objetivos (ATR), la autonomía de vehículos, los sistemas avanzados de asistencia al conductor (ADAS), la seguridad y para inteligencia, vigilancia y reconocimiento (ISR) terrestres y aéreos. Otros paquetes de software incorporados en productos basados en la visión incluyen localización y mapeo simultáneos (SLAM), prevención de colisiones, fusión de sensores, flujo óptico y seguimiento de objetos. Estas características computacionalmente exigentes, cuando se compilan para una arquitectura de hardware específica, se mapean a través de CPU, GPU, DSP, NPU, ISP y subsistemas de memoria dentro del sistema objetivo en chip (SoC). Gestionar esas tareas en procesadores heterogéneos modernos es un desafío de ingeniería significativo, pero permite grandes ventajas de potencia, latencia y gestión térmica en comparación con arquitecturas dependientes de la nube. En solo unas pocas generaciones de procesadores, los SoC avanzados han pasado de nodos de clase 10 nm a diseños de clase 7 nm, 5 nm y 4 nm, lo que resulta en un rendimiento sustancialmente mejorado por vatio.
Tabla 1 - Procesadores y módulos representativos de IA perimetral integrado
| PLATAFORMA | NODO DE PROCESO | RENDIMIENTO AI | RANGO DE POTENCIA | CASOS DE USO MEJOR ADAPTADOS |
|---|---|---|---|---|
| Kit de superdesarrollador NVIDIA Jetson Orin Nano | Clase de 8 nm | Hasta 67 TOPS INT8 | De 7 W a 25 W configurable | Creación de prototipos, robótica, IA de visión, IA perimetral multimodal y ecosistemas de desarrolladores con compatibilidad con CUDA y TensorRT. |
| NVIDIA Jetson AGX Orin | Clase de 8 nm | Hasta 275 TOPS | De 15 W a 60 W configurable | Robótica de alto rendimiento, percepción multicámara, sistemas autónomos y cargas de trabajo de IA perimetral más grandes. |
| Qualcomm Dragonwing QCS8550 | 4 nm | Hasta 48 TOPS INT8, dependiendo de la implementación del módulo | Depende de la aplicación | Cámaras inteligentes, drones industriales, robots móviles autónomos, cajas de IA perimetral y plataformas IoT de baja potencia altamente integradas. |
| Aceleradores de clase Hailo-8 / Hailo-10 Hailo-10-class | Depende del acelerador | Decenas a cientos de TOPS, dependiendo del dispositivo | Clase de acelerador de baja potencia | Aceleración de la visión en cámaras, puertas de enlace, sistemas industriales e implementaciones sensibles al coste o la energía. |
El procesamiento de señales de imagen y los algoritmos de detección de objetos de IA son computacionalmente costosos. Por ejemplo, los algoritmos avanzados de eliminación de ruido y superresolución de Teledyne FLIR OEM realizan hasta 100 000 operaciones por píxel por segundo (aproximadamente 2 billones de operaciones por segundo (TOPS) para una entrada de resolución de 640 x 512 a 60 fotogramas por segundo (fps)) y se ejecutan en un núcleo de GPU. La ejecución de modelos de detección de objetos grandes también consume mucha potencia de procesamiento y se ejecuta en el subsistema DSP (Qualcomm®) o GPU (NVIDIA®).
Para los sistemas térmicos, TOPS sin procesar es una métrica útil pero incompleta. El rendimiento real depende de la eficiencia con la que se asigne cada etapa de la canalización al recurso informático adecuado, cuántas veces deben moverse los datos de vídeo a través de la memoria, si la mejora de la imagen mejora o degrada la confianza del detector y si todo el sistema puede mantener las velocidades de fotogramas necesarias sin superar los límites de potencia o térmicos. Por lo tanto, los diseños de IA integrados más eficaces comienzan con el problema de detección y el entorno de implementación, no solo con la especificación del procesador.
Hay muchas variables a tener en cuenta al desarrollar e implementar un detector de objetos, incluida la arquitectura del procesador, la precisión deseada, la latencia o la velocidad de fotogramas aceptables, el ancho de banda de la memoria, el tiempo de ejecución del software, el tamaño del modelo y el presupuesto de potencia/térmico. En respuesta a las demandas de ejecutar detectores de objetos en procesadores integrados, se desarrollaron varias redes neuronales de baja potencia, incluidas You Only Look Once (YOLO) por Joseph Redmon de la Universidad de Washington en 2015 y MobileNet por Google en 2017. Desde entonces, el panorama de los detectores se ha ampliado sustancialmente para incluir modelos más nuevos de la familia YOLO, detectores basados en transformadores, arquitecturas sin supresión no máxima (NMS) y modelos diseñados para la percepción multitarea y la detección de vocabulario abierto. Para los sistemas térmicos y multiespectrales integrados, la pregunta más importante no es simplemente qué red es más reciente, sino qué modelo ofrece el rendimiento de detección, la latencia, el consumo de energía y la fiabilidad de integración requeridos en el procesador seleccionado.
YOLO revolucionó la detección de objetos con su enfoque de un solo paso. A diferencia de las redes neuronales convolucionales (RCNN) basadas en regiones que implican múltiples etapas, como propuestas de regiones seguidas de clasificación, YOLO logra la detección y localización en un solo paso hacia adelante de la red. Al dividir una imagen de entrada en una rejilla y predecir múltiples cuadros delimitadores y probabilidades de clase simultáneamente para cada celda de rejilla, el algoritmo YOLO ofrece velocidad y precisión. Los detectores de una etapa utilizan una sola red de alimentación directa para predecir directamente clases y ubicaciones de objetos. El detector de disparo único (SSD) mejora YOLO en varios aspectos, incluido el uso de múltiples escalas de características para la predicción y el uso de cuadros predeterminados y relaciones de aspecto para ajustar a diferentes formas de objeto. Aunque los enfoques de dos etapas suelen producir una mayor precisión, los enfoques de una etapa suelen funcionar con mayor eficiencia. Los detectores más nuevos continúan mejorando este espacio comercial a través de una mejor agregación de características, un diseño consciente de la cuantificación, mecanismos de atención inspirados en transformadores y arquitecturas fáciles de implementar que reducen la sobrecarga posterior al procesamiento.
4. Diseño de una red neuronal para plataformas integradas - Presentación de Pelee
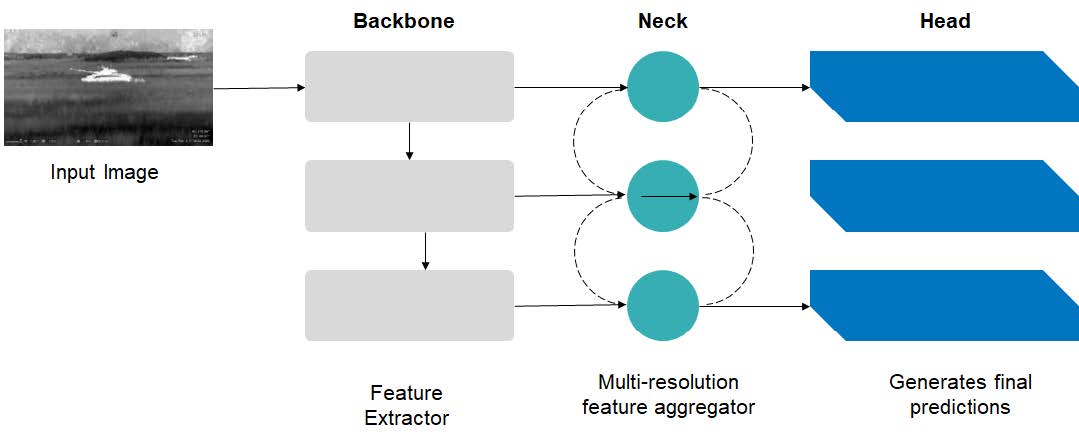
Figura 1 - Arquitectura del detector de objetos (Juan R. Terven, 2023)
El diseño de la detección de objetos para cámaras térmicas requiere un punto de partida diferente al de seleccionar un modelo de visión de uso general. Las imágenes térmicas suelen contener menos texturas visuales que las imágenes visibles; los objetivos pueden ocupar solo un pequeño número de píxeles y las condiciones ambientales pueden cambiar el contraste, la forma aparente y el desorden del fondo. Estos factores hacen que sea importante diseñar conjuntamente el detector con el sensor, la óptica, la tubería de procesamiento de imágenes y el hardware de implementación.
El OEM de Teledyne FLIR amplió el enfoque de una sola pasada con el desarrollo de su red Pelee (patente pendiente). Las redes neuronales convolucionales (CNN) se componen de tres bloques principales: el extractor de características o red troncal, un agregador o cuello de características y el detector de cabeza u objeto. Pelee cuenta con un nuevo diseño de red troncal que está construido con un patrón de conectividad denso para fomentar la reutilización de funciones y una capa densa bidireccional para obtener diferentes escalas de campos receptivos. Pelee incorpora un nuevo bloque de fusión de funciones (FFB) basado en la Red de Pirámides de Funciones de Agregación de Rutas (PANet). Diseñado teniendo en cuenta la detección de objetivos pequeños, el nuevo FFB adopta una estrategia de fusión tardía, que tiene como objetivo garantizar que cada mapa de características de la salida conserve la información detallada aprendida de las capas superficiales y adquiera características semánticas de alto nivel.
Tabla 2 - Recursos de la red troncal
| MARCO | RED TRONCAL | COSTE COMPUTATIVO (FLOP) | ||
|---|---|---|---|---|
| Red troncal | Total | Parte de la red troncal | ||
| SSD | VGG | 31,9 | 34,2 | 93,3 % |
| RefineDet | VGG | 31,9 | 37,38 | 85,3 % |
| YOLOv3 | DarkNet 53 | 14,51 | 19,54 | 74,2 % |
| RetinaNet | ResNet101 | 15,48 | 34,51 | 53,4 % |
La red troncal afecta directamente a la memoria, la velocidad y el rendimiento del detector de objetos. En SSD CNN, más del 90 % del coste de cálculo lo consume la red troncal. La CNN de Teledyne FLIR OEM incorpora un nuevo diseño de red troncal que evita el uso de un bloque de apriete y excitación, selecciona cuidadosamente las funciones de activación según el hardware y ajusta la anchura y profundidad de la red según el hardware.
Por lo tanto, Pelee debe entenderse como una arquitectura de detector orientada a la implementación y específica de la aplicación en lugar de como un ganador de referencia de uso general en cada nueva familia de modelos. Su valor está en el espacio comercial de ingeniería que importa para las cámaras térmicas inteligentes: rendimiento de objetivo pequeño, latencia predecible, eficiencia de memoria, opciones de activación conscientes del hardware y la capacidad de funcionar junto con las funciones Prism ISP, estabilización de vídeo, seguimiento y otras cargas de trabajo de percepción dentro de un envolvente SWaP restringido.
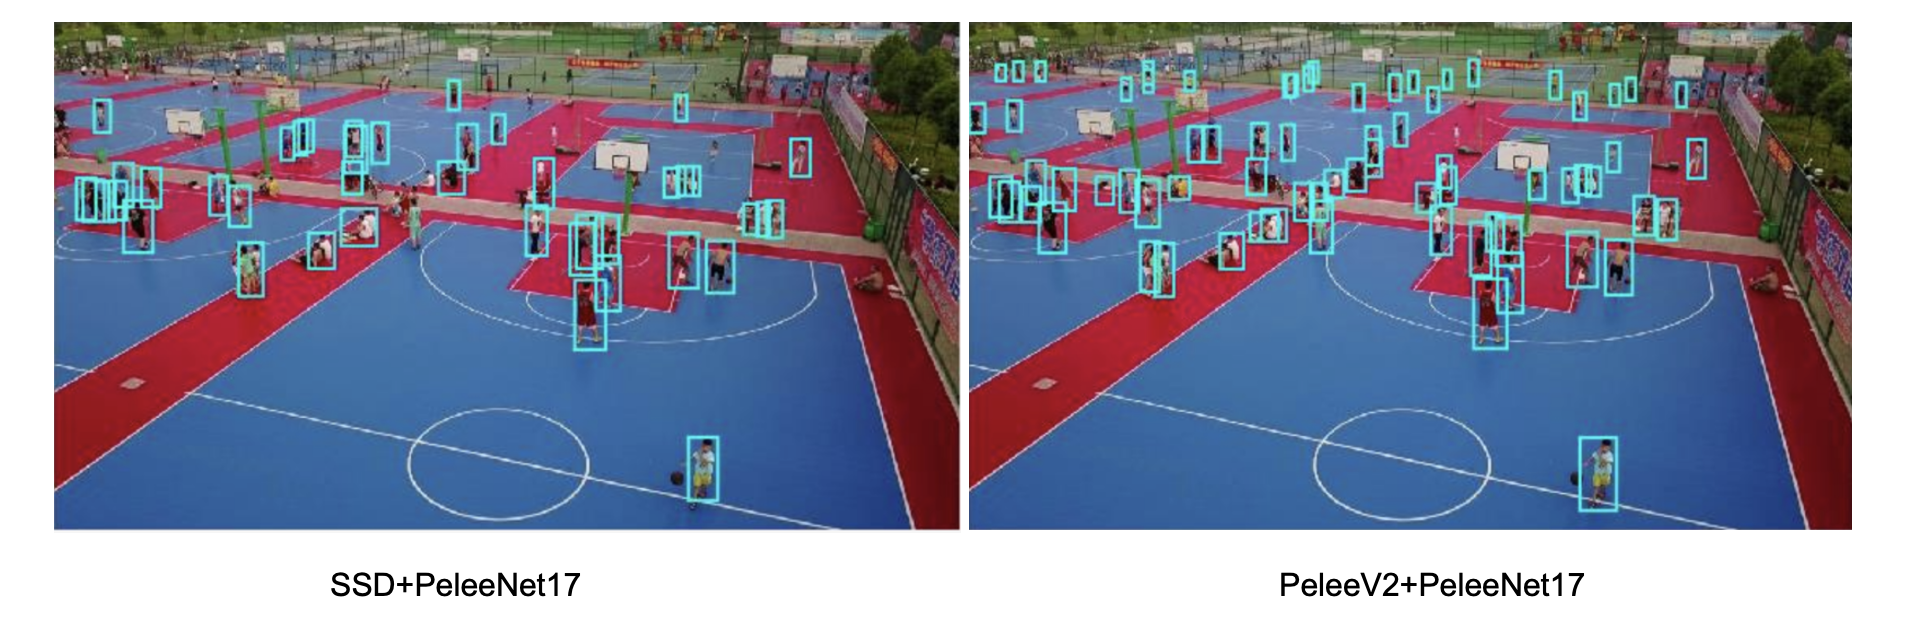
Figura 2 - Rendimiento del modelo basado en la red troncal de Pelee
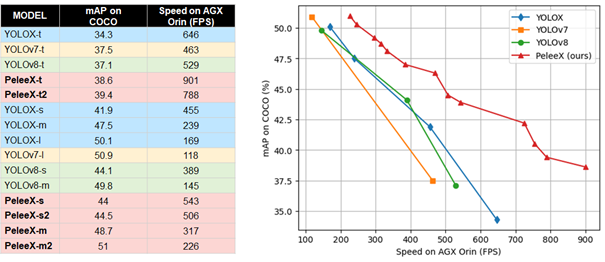
Figura 3: Comparación del rendimiento de Pelee frente a YOLO Networks
5. Optimización
Cuantificación
La cuantificación es la compresión de valores de punto flotante en parámetros de red neural para mejorar la latencia del modelo, reducir la huella de memoria y reducir el consumo de energía al ejecutar la inferencia. El entrenamiento de modelos generalmente se realiza utilizando datos de punto flotante de 32 bits en potentes sistemas basados en GPU. La inferencia en procesadores integrados se optimiza entonces utilizando FP16, FP8, INT8, INT4 u otras precisiónes compatibles con el tiempo de ejecución dependiendo del procesador, la arquitectura del modelo, los datos de calibración y las compensaciones de precisión aceptables.
El OEM de Teledyne FLIR utiliza INT8 para reducir la huella de memoria, el tiempo de computación y el consumo de energía porque sigue siendo un compromiso práctico entre la precisión y la velocidad para muchas cargas de trabajo de visión integradas. Sin embargo, la implementación ahora depende cada vez más de flujos de trabajo de cuantificación explícitos, datos de calibración representativos, formación consciente de la cuantificación cuando sea necesario y generación de motores específicos para el objetivo. Los desarrolladores deben validar FP16, INT8 y opciones de menor precisión en el hardware real porque el rendimiento, la precisión, el uso de memoria y el comportamiento térmico pueden variar significativamente entre GPU, DSP, NPU e implementaciones de tiempo de ejecución específicas del proveedor. La recuperación de recursos informáticos ofrece a los desarrolladores la flexibilidad de añadir más capacidades, incluida la inferencia en tiempo real en dos o más fuentes de cámara.
Fresado
El podado es un método utilizado para reducir las rutas de datos no utilizadas en la red neural determinando la importancia de cada unidad y eliminando rutas pasivas. Después del entrenamiento, muchas de las neuronas de la red tienen un valor de peso de 0, por lo que estas neuronas pueden eliminarse a través de un proceso secundario de entrenamiento de la red después de la cuantificación. Los métodos de poda actuales incluyen poda de peso, poda de canal y poda de neuronas, cada uno con sus ventajas y desventajas.
Los criterios para determinar la importancia de la unidad pueden afectar a la precisión. El uso de métodos de aprendizaje restringido puede mejorarlo, aunque la implementación es compleja. El método de búsqueda aleatoria de poda es fácil de implementar, pero el rendimiento del modelo de red es limitado en comparación con otros métodos que lo mejoran. Por lo tanto, cada método debe seleccionarse junto con el escenario de aplicación real. No hay un único método que pueda sintetizar la complejidad y la eficiencia de compresión del modelo.[i]
Gestión térmica
Para muchas categorías de productos, incluidos drones y visores de armas, el consumo de energía es una restricción de diseño crítica. El alto consumo limita el tiempo de funcionamiento, añade desafíos logísticos de soporte y añade complejidad y costes para la gestión térmica. Para algunos dispositivos que funcionan con batería, la opción es utilizar una matriz de puertas programable en campo (FPGA) o un procesador de circuito integrado específico de la aplicación (ASIC) para mantener la potencia al mínimo absoluto, pero no están disponibles software ISP y análisis de terceros, ya que estas bibliotecas normalmente se compilan para ejecutarse en procesadores de máquina RISC avanzada (ARM) y otros núcleos que utilizan componentes y marcos de código abierto como OpenCV. Aunque este no es el caso de los productos con más limitaciones de potencia, las demandas de potencia de los procesadores integrados de nueva generación fabricados en nodos de 4 nm a 7 nm ofrecen a los diseñadores de sistemas muchas opciones para añadir capacidades de alto valor a los productos.
Para un sistema que ejecuta varias cámaras y varias rutinas de funciones como un detector de objetos, rastreador de objetivos y mejora de contraste local, el desarrollador alcanzará el límite superior del rendimiento del procesador y generará mucho calor. Para ayudar a gestionar esto, los desarrolladores de software pueden crear parámetros de configuración que se pueden establecer o ajustar dinámicamente. Por ejemplo, para muchas aplicaciones no es necesario inferir a velocidad de fotogramas. Al reducir la salida de inferencia a 10 fps o menos, el perfil de potencia de toda la pila de software puede gestionarse para ajustarse al presupuesto de potencia.
6. La potencia de desarrollo rápido
de procesadores móviles
Ejecutar modelos de CNN y algoritmos de CI es extremadamente exigente desde el punto de vista computacional. Hasta hace poco, los procesadores integrados no tenían la capacidad de cumplir con las cargas de trabajo de IA y CI. La IA requiere un paralelismo masivo de funciones de acumulación múltiple. Las GPU tradicionales pudieron hacer paralelismo de forma similar para los gráficos, por lo que se reutilizaron para aplicaciones de IA, especialmente para el entrenamiento de modelos. Como resultado, NVIDIA se ha establecido como el jugador dominante en el entrenamiento de modelos.
Los procesadores móviles e integrados actuales son asombrosas hazañas de la ingeniería. Por ejemplo, el SoC Dragonwing QCS8550 de Qualcomm es un diseño de 4 nm que cuenta con CPU, GPU, DSP, NPU, visión artificial y recursos ISP dedicados para aplicaciones exigentes de IoT e IA perimetral. El ISP integrado y los recursos de visión artificial admiten funciones como eliminación de ruido de vídeo, estabilización, corrección de imagen, balance de blancos, procesamiento de color, control automático de ganancia, enfoque y otras funciones de la cámara. Esta clase de chip requiere una enorme inversión en desarrollo y depende de la capacidad avanzada de fundición, las herramientas de software y el soporte del ecosistema a largo plazo.
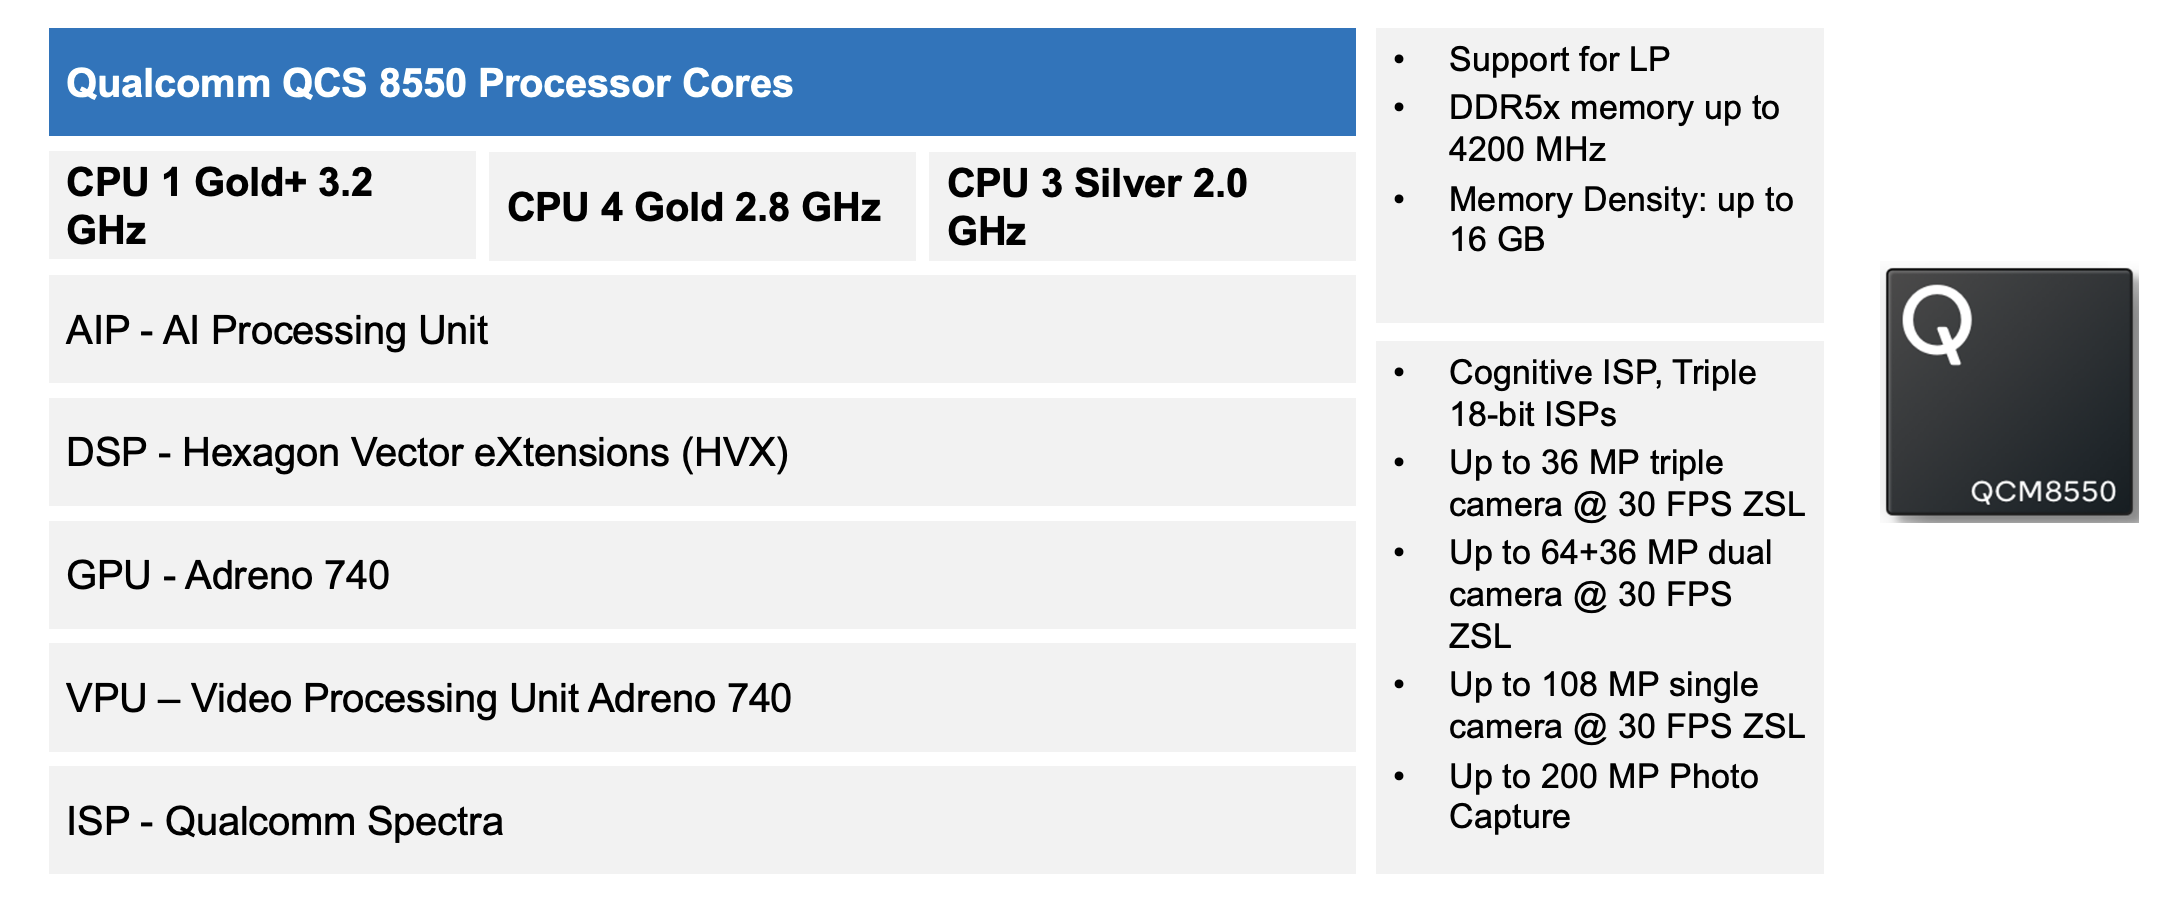
Figura 5 - Núcleos del procesador QCS 8550
El OEM de Teledyne FLIR quería crear una plataforma en la que los clientes pudieran construir sus productos y permitiría la creación de pilas de software altamente integradas y minimizar el coste, la latencia y la potencia utilizando un solo procesador cuando fuera práctico. Este ha sido el objetivo en varias generaciones de plataformas, incluida la selección del procesador Intel® Myriad™ para el módulo de cámara termográfica de infrarrojos (IR) Boson® OEM de Teledyne FLIR. La arquitectura de chip de Myriad no podía satisfacer las necesidades de computación más pesadas para imágenes computacionales o detectores de objetos basados en CNN. Con la introducción de los procesadores de clase NVIDIA Xavier, NVIDIA Jetson Orin, Qualcomm RB5/QCS5165 y Qualcomm QCS8550-class, resultó práctico ejecutar varias pilas de software distribuidas entre núcleos de procesador y aceleradores específicos.
Descripción general del sistema en chip (SoC)
Los procesadores integrados actuales aprovechan lo último en nodos de fundición, lo que permite diseños multinúcleo con memoria unificada. Los proveedores de procesadores ofrecen un soporte de desarrollo muy completo y los desarrolladores pueden implementar su código en estos procesadores multinúcleo para maximizar el rendimiento al tiempo que cumplen con los presupuestos de energía y térmica.
CPU
La funcionalidad principal de la CPU es recuperar instrucciones de la memoria de acceso aleatorio (RAM) y luego decodificar y ejecutar las instrucciones. Las CPU son procesadores generalistas diseñados para ejecutar rutinas que manejan cargas de trabajo secuenciales. Muchas CPU tienen procesadores vectoriales integrados para acelerar algunas operaciones (por ejemplo, NEON en CPU basadas en ARM). Varias de las capacidades de productos digitales de OEM de Teledyne FLIR se ejecutan en núcleos de CPU, incluido el rastreador de vídeo de correlación Prism ISP y la estabilización de vídeo electrónica. Dado el gran número de núcleos de CPU disponibles en los SoC de la generación actual, los desarrolladores tienen una tremenda flexibilidad para optimizar el rendimiento y la potencia. Las CPU no son adecuadas para tareas que requieren un gran número de operaciones matemáticas por píxel. Las CPU tienen limitaciones de rendimiento y consumen una potencia relativamente alta por operación.
GPU
Las cargas de trabajo de IA y CI son masivas, lo que exige una cantidad significativa de ancho de banda y potencia de procesamiento. Los diseñadores de procesadores han creado potentes arquitecturas de chip que integran memoria, seguridad y conectividad de datos en tiempo real. Las CPU tradicionales normalmente carecen del rendimiento de procesamiento necesario, pero son ideales para realizar tareas secuenciales. Las GPU pueden gestionar el paralelismo de las funciones de acumulación múltiple de IA y se pueden aplicar a aplicaciones de IA. De hecho, las GPU pueden servir como aceleradores de IA, mejorando el rendimiento para redes neuronales y cargas de trabajo similares. Las GPU pueden tener miles de núcleos de computación y se utilizan para muchas tareas de procesamiento paralelo. Las GPU son especialmente útiles para los modelos de entrenamiento. Sin embargo, las GPU consumen una potencia significativa y tienen mayores requisitos de memoria en chip. Por este motivo, los procesadores móviles modernos utilizan coprocesadores de IA dedicados que utilizan procesadores de señales digitales (DSP) para ejecutar la inferencia en el perímetro.
DSP
Los DSP son subsistemas de SoC especializados y de bajo consumo optimizados para ejecutar operaciones matemáticas. Utilizan palabras de instrucciones amplias para ayudar a maximizar el procesamiento por ciclo de reloj. Sin embargo, no son tan fáciles de programar y requieren familiarizarse con las características del hardware DSP, el entorno de programación y la optimización del software DSP para lograr el mejor rendimiento. El procesador tensor (HTP) Hexagon Qualcomm es un acelerador de IA que es adecuado para ejecutar cargas de trabajo de IA computacionalmente intensivas. Para obtener un mejor rendimiento y ejecutar un modelo de IA en HTP, un modelo debe cuantificarse con una de las precisiónes compatibles: INT4, INT8, INT16 o FP16.
ISP
Debido a que la fotografía digital es la primera línea de la batalla competitiva en el sector de los teléfonos móviles, los proveedores de procesadores móviles incorporan bloques de propiedad intelectual (IP) de silicio dedicados para realizar funciones de mejora de imagen que incluyen reducción de ruido, corrección de distorsión de la lente, balance de blancos, exposición automática, enfoque automático, desmosaicing y compresión de imagen. A nivel de sistema, normalmente se necesita un ajuste de ISP para optimizar los parámetros y varios filtros a un sensor de imagen y lente específicos. El ajuste fino de ISP es un sector en sí mismo. Muchos proveedores de SoC ofrecen bibliotecas ISP para sensores de imagen populares, lo que puede ahorrar a los desarrolladores de sistemas una inversión significativa.
Hay poca justificación para que los proveedores de procesadores móviles diseñen y fabriquen un ISP de cámara térmica. Aun así, las ventajas del procesamiento de señales de imagen son valiosas, por lo que Teledyne FLIR OEM ha desarrollado un conjunto completo de características ISP que incluyen mapeo de tonos de 16 a 8 bits (control automático de ganancia), eliminación de ruido espacial temporal, superresolución, mitigación de turbulencias y estabilización electrónica de imagen. La mayoría de estos algoritmos se ejecutan en GPU dadas las importantes demandas de procesamiento.
Memoria
Dadas las altas velocidades de datos en las secuencias de vídeo digital y el hecho de que los datos pueden leerse repetidamente mediante múltiples algoritmos, la capacidad de memoria y el ancho de banda de memoria son fundamentales para un procesamiento eficiente de la señal. Mediante una combinación de velocidades de reloj aumentadas, mayor ancho de banda de memoria, aceleración de IA dedicada y optimización de software mejorada, el modelo de IA existente más grande del OEM de Teledyne FLIR (resolución de entrada de 768 x 768 píxeles) se ejecuta en 6 ms en el Qualcomm QCS8550 frente a 33 ms en el QRB5165. Esto representa un aumento de más de 5X en la velocidad de inferencia y proporciona un margen seguro para lograr la inferencia a velocidad de fotogramas para las cámaras de resolución SXGA (1280 x 1024) de próxima generación.
7. Marcos
Los marcos de IA son bloques fundamentales que dan forma a cómo se crean, optimizan e implementan los sistemas inteligentes. Estos marcos, equipados con bibliotecas y funciones prediseñadas, permiten a los desarrolladores crear sofisticados algoritmos de IA sin tener que diseñar todas las funciones desde cero. En los sistemas de IA perimetral de producción, el debate sobre el marco ahora se extiende más allá de la formación de modelos para incluir formatos de exportación, optimización del tiempo de ejecución, herramientas de cuantificación, compiladores específicos de hardware, pruebas de regresión, estrategias de actualización inalámbrica y supervisión del rendimiento a nivel de flota.
PyTorch sigue siendo ampliamente utilizado para investigación, experimentación y desarrollo de modelos debido a su flexibilidad y modelo de ejecución fácil de usar. Su gráfico de cálculo dinámico permite a los desarrolladores cambiar el comportamiento de los modelos sobre la marcha y utilizar operaciones de flujo de control Python, lo que lo hace adecuado para arquitecturas de modelos complejos, prototipos rápidos y experimentación iterativa.
TensorFlow sigue siendo importante en entornos de producción y flujos de trabajo de implementación móvil, especialmente cuando TensorFlow Lite o LiteRT ya están integrados. Sin embargo, la implementación integrada moderna rara vez es una opción simple de PyTorch frente a TensorFlow. Una ruta de producción común es entrenar en PyTorch o TensorFlow, exportar a ONNX u otra representación portátil, optimizar el gráfico, cuantificar el modelo, compilar a un tiempo de ejecución como TensorRT, ONNX Runtime, OpenVINO, LiteRT/TensorFlow Lite o Qualcomm AI Engine Direct y luego validar la latencia, la precisión, la potencia y el comportamiento térmico en el dispositivo de destino. Por lo tanto, el mejor marco es el que admite la canalización de implementación completa para el procesador y la aplicación seleccionados, no solo el que sea más cómodo durante la formación.
8. Tubería de procesamiento de vídeo
La canalización de procesamiento de vídeo es donde el enfoque de Teledyne FLIR OEM se diferencia más. En lugar de tratar la cámara, el ISP, el detector, el rastreador y el procesador integrado como componentes independientes, la tubería está diseñada como un sistema conectado. Cada etapa afecta a la siguiente: la eliminación de ruido cambia la textura del objetivo, la mejora del contraste cambia la distribución de entrada del modelo, la estabilización mejora la consistencia temporal, la superresolución puede mejorar el detalle efectivo y el seguimiento convierte las detecciones fotograma a fotograma en información persistente. La optimización de estas interacciones es esencial para una percepción fiable del borde.
El OEM de Teledyne FLIR desarrolló Prism ISP, una colección de bibliotecas de software de procesamiento de imágenes para termografías que incluyen mejora de contraste local (LCE), reducción de ruido espacial y temporal, estabilización electrónica de imágenes, mitigación de turbulencias, superresolución y varias técnicas de fusión de vídeo. Estas funciones mejoran la calidad de la imagen para la interpretación humana, al tiempo que dan forma a la información presentada para la detección posterior y los algoritmos de seguimiento. El objetivo es hacer que el vídeo tenga un mejor aspecto y mejorar la fiabilidad, la eficiencia y la capacidad de implementación de la tubería de percepción térmica completa, al tiempo que se minimizan los requisitos de energía y el coste. Los módulos de cámara térmica de Teledyne FLIR OEM no incluyen procesadores integrados para ejecutar Prism ISP. Con la disponibilidad de procesadores móviles e integrados modernos, ahora es práctico añadir un módulo electrónico accesorio con la potencia para ejecutar ISP, detección y algoritmos de seguimiento a velocidades de fotogramas de vídeo útiles mientras se cumplen las limitaciones térmicas y de potencia del mundo real.
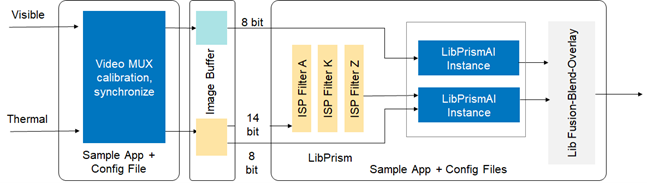
Figura 6 - Tubería de procesamiento de vídeo Prism
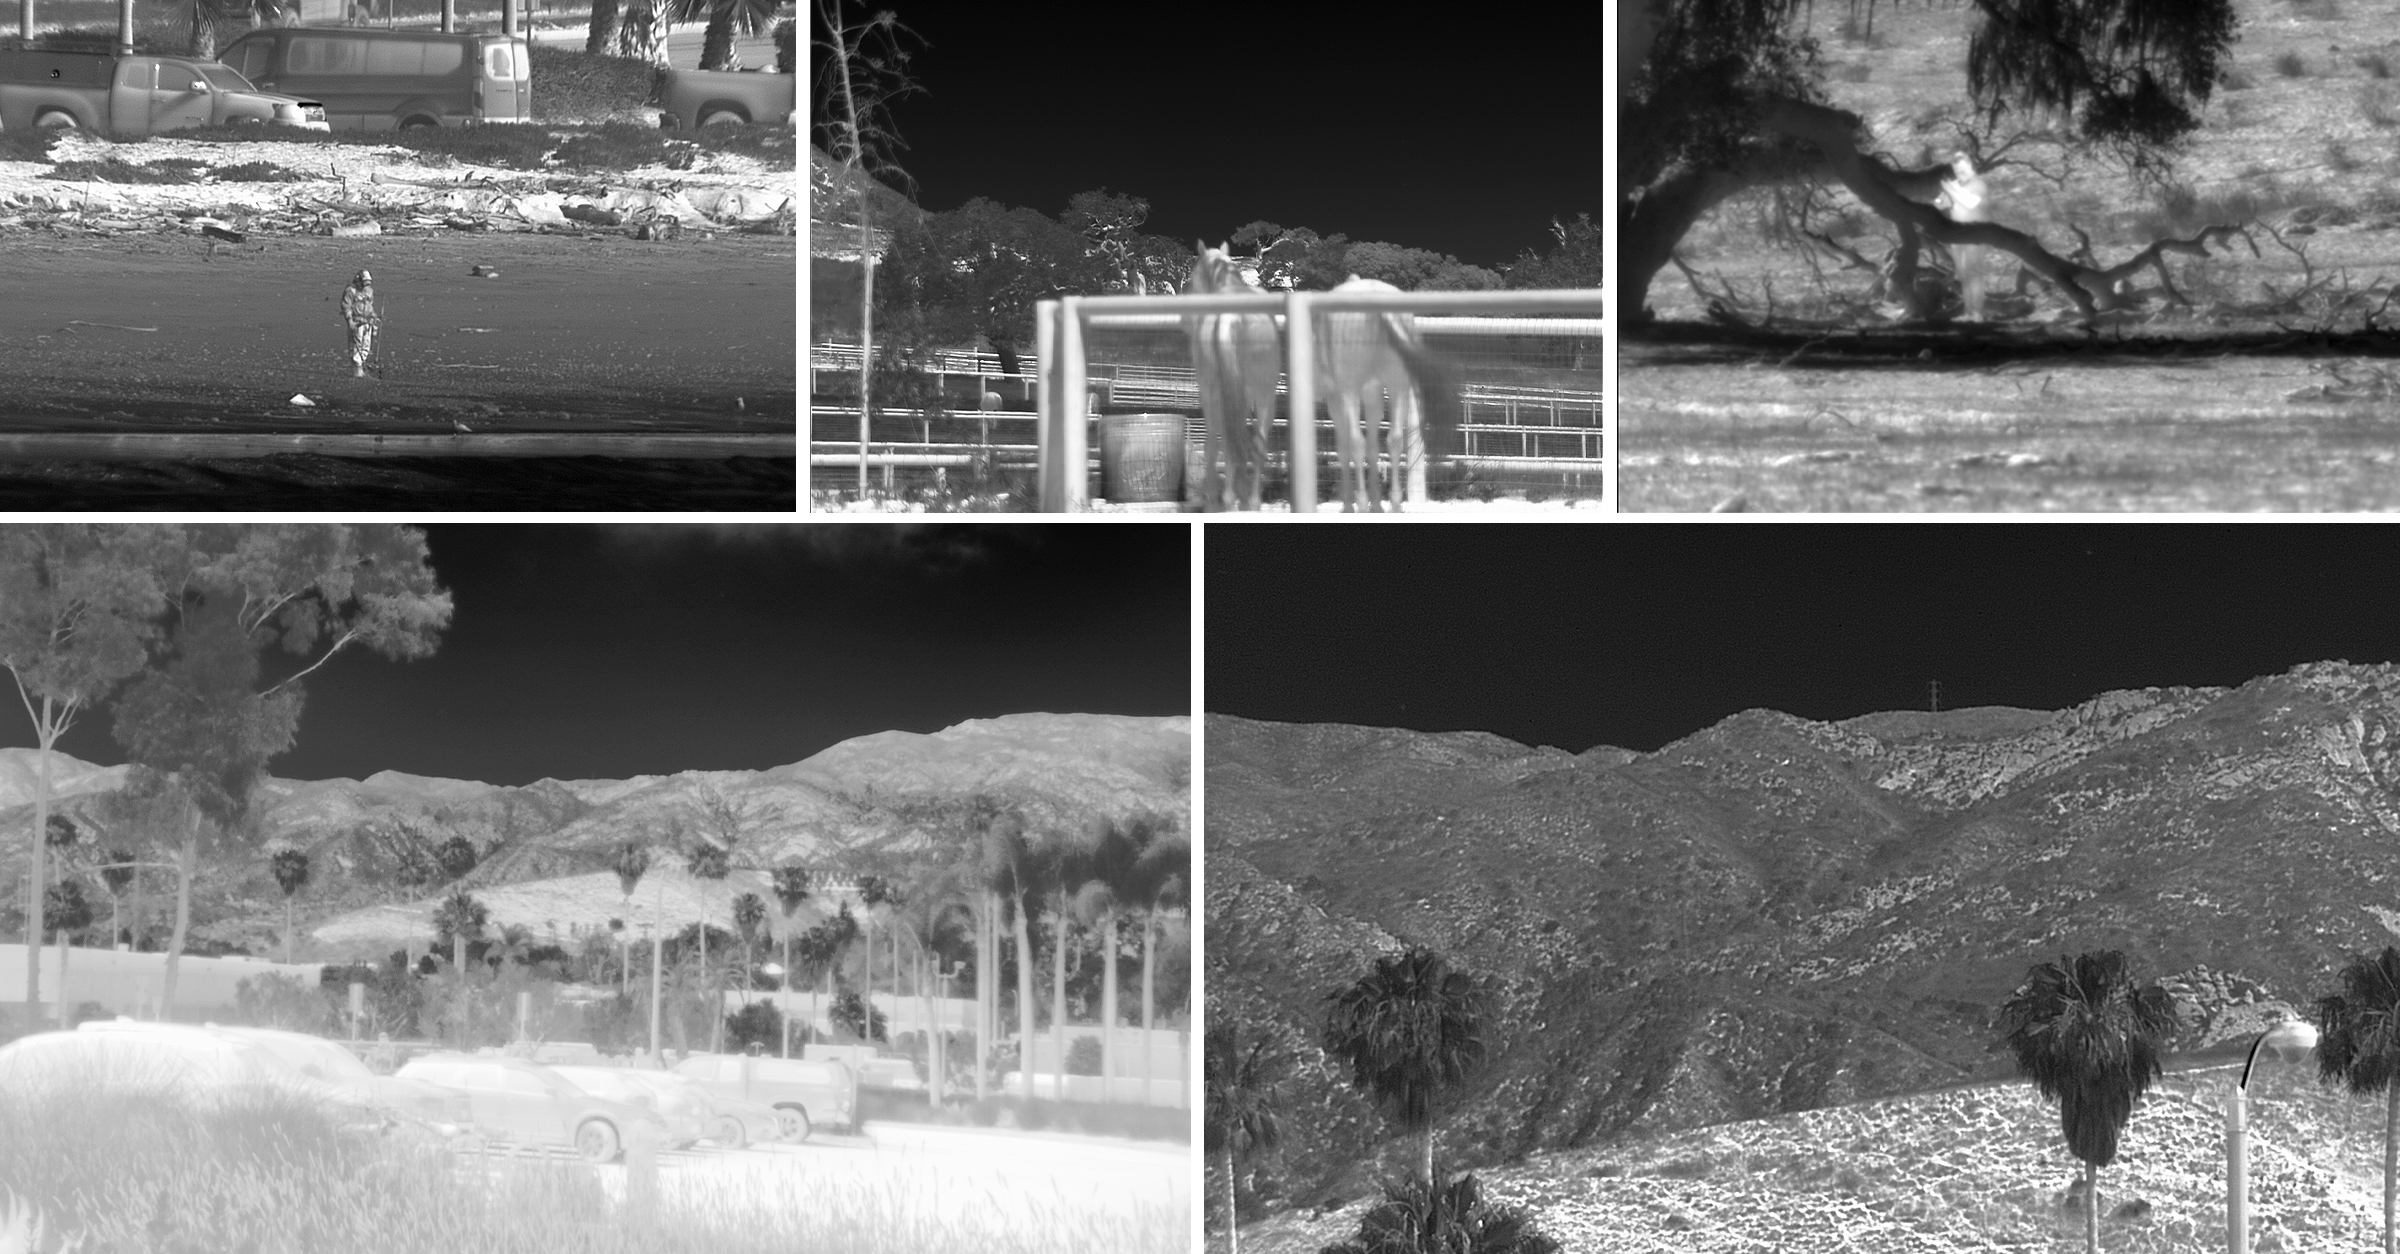
La termografía se utiliza en muchos casos de uso para visualizar objetos: a metros de distancia para inspección y extinción de incendios; a varios kilómetros en inteligencia, vigilancia y reconocimiento (ISR); y desde perspectivas aéreas, basadas en torre y a nivel del suelo. La combinación de rango, perspectiva y condiciones ambientales basadas en el día, la noche y el clima crea desafíos de imágenes del mundo real que se pueden mitigar con las funciones del algoritmo Prism ISP.
9. Funciones Prism ISP
Mitigación de turbulencias
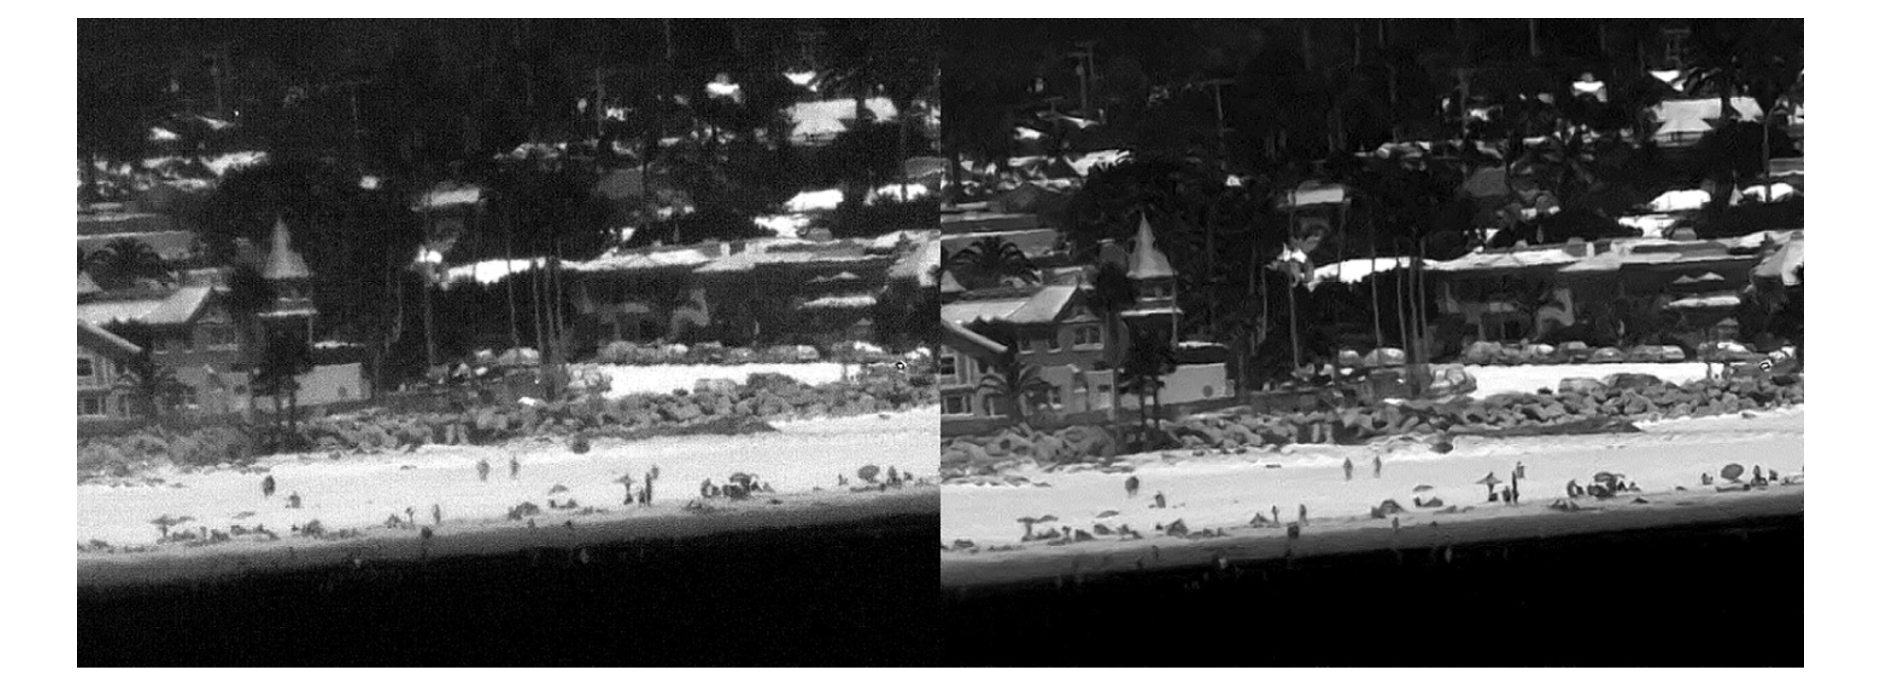
Figura 7: comparación sin mitigación de turbulencia (izquierda) y con mitigación de turbulencia (derecha)
Las turbulencias atmosféricas se refieren al movimiento irregular y caótico del fluido o el aire caracterizado por fluctuaciones de velocidad, presión y densidad. Las turbulencias afectan a la transmisión de fotones porque la ganancia solar de la superficie hace que la atmósfera se mezcle. Agita el aire y provoca que el vapor de agua, el humo y otras sustancias alteren la refracción de la señal infrarroja. Las técnicas avanzadas eliminan los efectos de distorsión al tiempo que mantienen una buena calidad del elemento de imagen temporal, lo que significa que los objetos en movimiento no se transforman en manchas o rayas indistinguibles. Esto es fundamental al detectar objetivos, incluidas personas y vehículos, utilizando IA.
Para la detección y el seguimiento de IA, la mitigación de turbulencias es más que una función de calidad de imagen. La distorsión, el brillo y el movimiento aparente pueden reducir la confianza del detector y hacer que las pistas sean menos estables. Al mejorar la coherencia temporal antes de la inferencia y el seguimiento, la tubería puede ofrecer información de objetivos más fiable sin depender únicamente de modelos más grandes o presupuestos informáticos más altos.
Los objetivos principales de los algoritmos de mitigación de turbulencias son mejorar la calidad de la señal, reducir el ruido y restaurar la claridad y la estabilidad en condiciones de turbulencia. El algoritmo Prism ISP emplea varias técnicas matemáticas y de procesamiento de señales para analizar y procesar los datos afectados por las turbulencias.
- Adquisición de datos: El primer paso es adquirir los datos afectados por las turbulencias. Esto se presenta en forma de fotogramas de imagen.
- Preprocesamiento: Los datos adquiridos se procesan previamente para eliminar ruidos o artefactos que no están directamente relacionados con turbulencias. Esto implica técnicas de filtrado, reducción de ruido y calibración para mejorar la calidad de la señal.
- Estimación de turbulencia: Es esencial estimar las características de turbulencia presentes en los datos. Esto implica analizar las propiedades estadísticas de las fluctuaciones e identificar parámetros relevantes como la intensidad de la turbulencia, la longitud de correlación y las escalas de tiempo.
- Deconvolución o reconstrucción: Las técnicas de deconvolución intentan revertir los efectos borrosos causados por las turbulencias. Los algoritmos de deconvolución suelen utilizar modelos matemáticos de turbulencia o conocimiento empírico para restaurar la señal original.
- Filtrado adaptativo: Las condiciones de turbulencia pueden variar con el tiempo y el espacio, por lo que muchos algoritmos de mitigación de turbulencias utilizan técnicas de filtrado adaptativo. Estos métodos ajustan dinámicamente los parámetros de filtrado en función de los parámetros de turbulencia estimados para optimizar la compensación entre la reducción de ruido y la conservación de las características esenciales de la señal.
- Posprocesamiento: Después de los pasos de mitigación de turbulencias, se puede realizar un posprocesamiento adicional para mejorar aún más la calidad y reducir los artefactos en la salida final. Dependiendo de la aplicación específica, esto puede implicar técnicas como eliminación de ruido, nitidez, mejora del contraste o extracción de características.
Superresolución
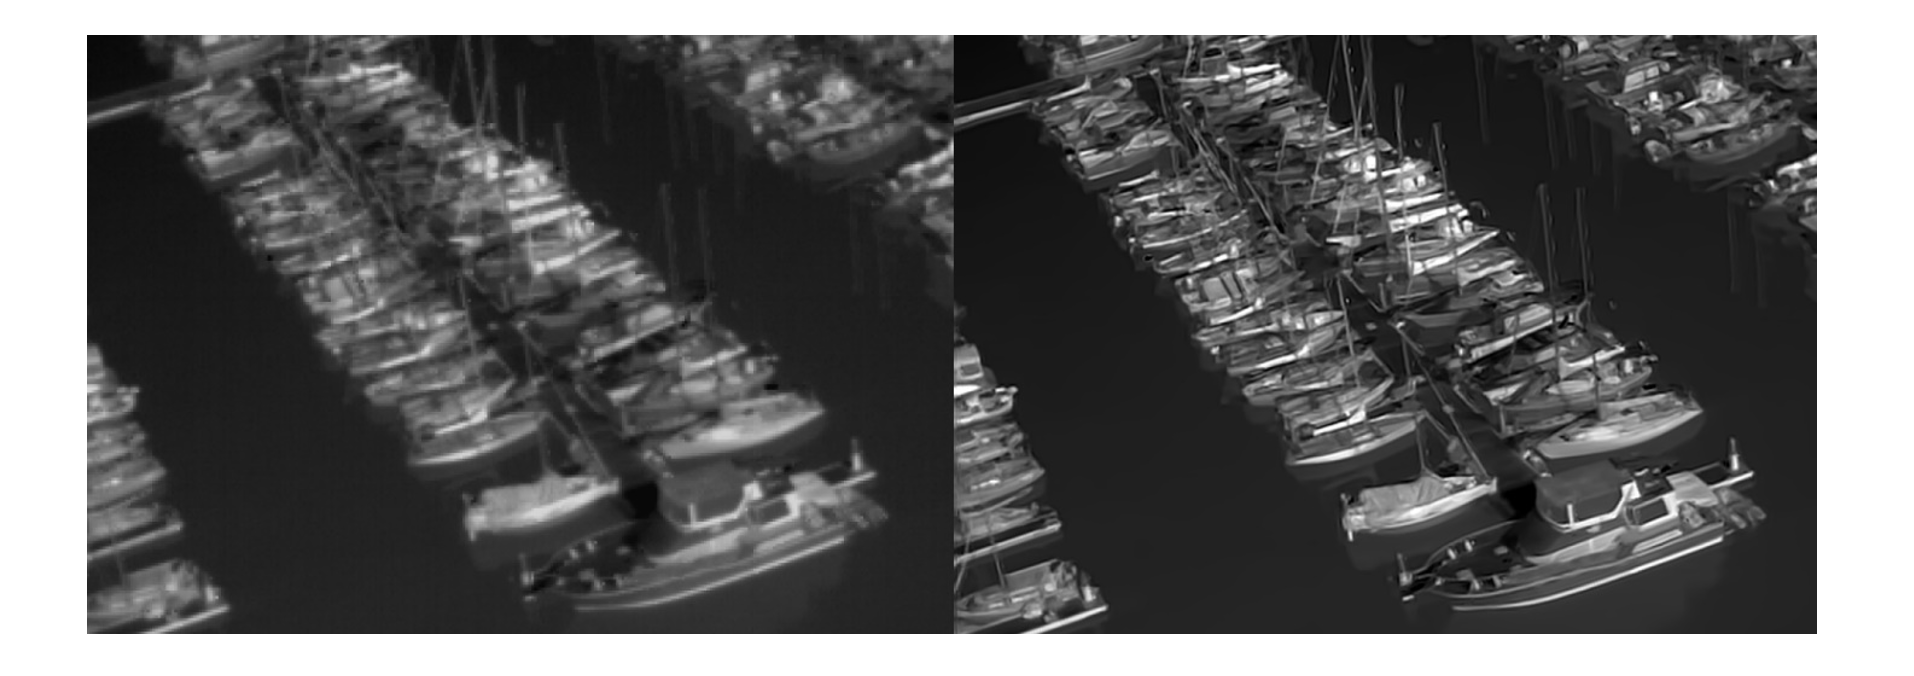
Figura 8: comparación sin superresolución (izquierda) y con superresolución (derecha)
La superresolución multifotograma es una potente técnica que tiene como objetivo reconstruir una imagen de alta resolución a partir de una o más imágenes de baja resolución. La resolución óptica de un sistema está limitada por el límite de difracción establecido por la apertura del sistema y la resolución de muestreo del detector. Una apertura pequeña y un sensor de baja resolución darán como resultado un sistema más barato y pequeño que dará como resultado imágenes de mala calidad con bordes muy aliasados y/o borrosos. Esto es especialmente cierto cuando los objetivos de largo alcance se capturan utilizando una óptica de larga distancia focal que escala los efectos de la difracción cuando se combina con un tamaño de apertura finito. Al emplear algoritmos sofisticados, la superresolución reconstruye imágenes de alta resolución utilizando datos de las entradas degradadas. Aunque los métodos tradicionales se han centrado principalmente en explotar las correlaciones espaciales inherentes dentro de las imágenes de baja resolución, los últimos avances han demostrado la eficacia de aprovechar las técnicas de aliasing para lograr resultados superiores.
En una canalización de percepción, la superresolución también puede afectar al rango de detección, la clasificación de objetivos pequeños y la confianza del operador. El beneficio debe evaluarse a nivel de sistema porque los artefactos de nitidez o reconstrucción pueden ayudar a la interpretación visual, pero también pueden cambiar la distribución de entrada vista por un modelo de IA. Esto refuerza la necesidad de ajustar ISP y detección juntos en lugar de como funciones aisladas.
Estabilización de imagen
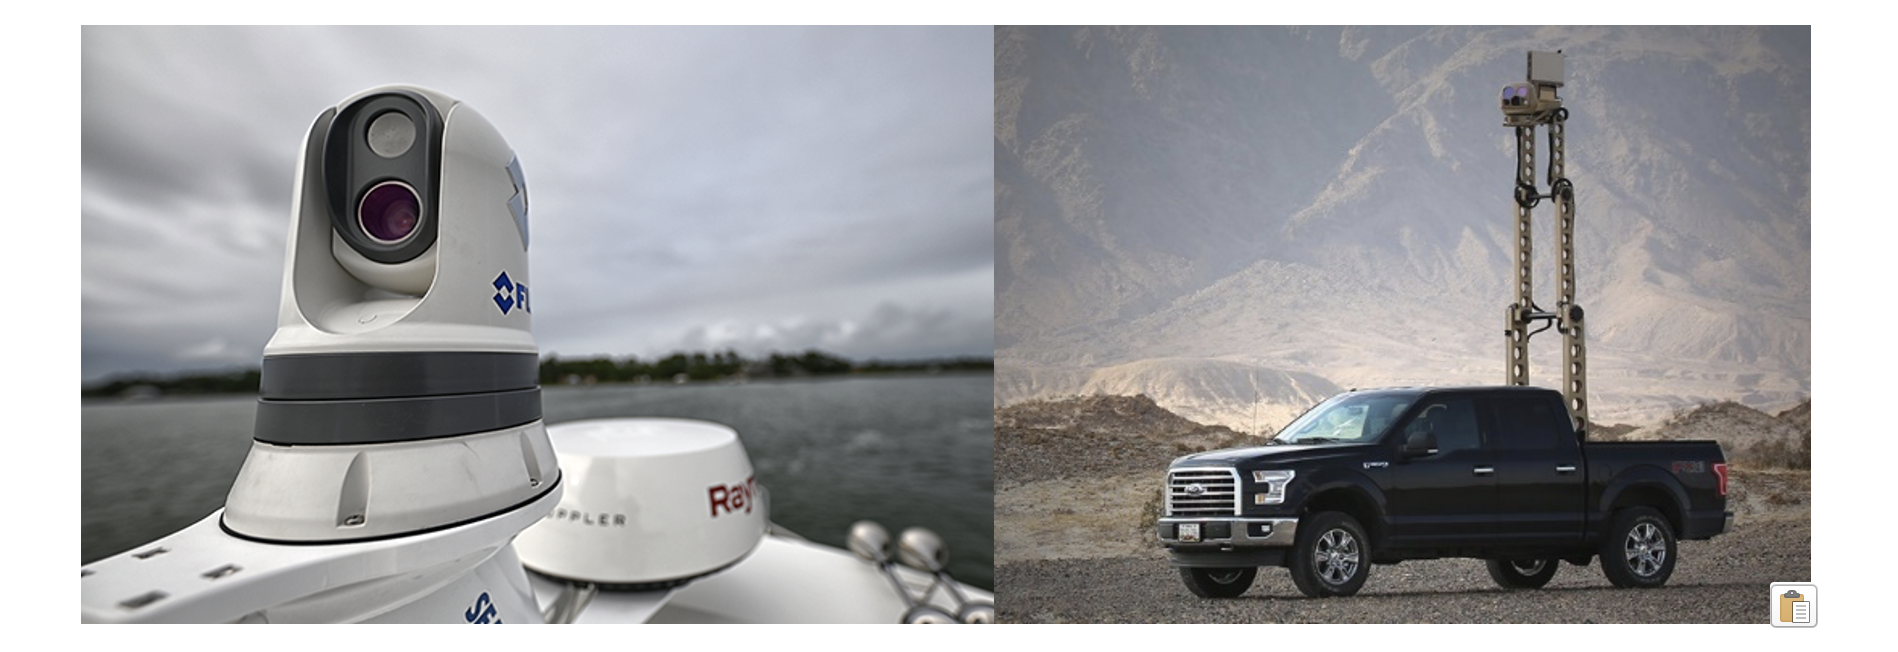
Figura 9 - Aplicaciones típicas para la estabilización electrónica
Las cámaras suelen montarse en plataformas móviles como vehículos terrestres, embarcaciones marinas, aeronaves, drones o torres. El movimiento de la plataforma se transfiere directamente a la imagen de vídeo, lo que puede provocar fatiga del espectador y mala calidad de imagen, lo que afecta a la conciencia situacional y a la fidelidad de las pruebas. La estabilización electrónica elimina la mayor parte de la distorsión de imagen inducida por el movimiento, especialmente cuando se obtienen imágenes a través de una óptica de zoom de campo de visión estrecho utilizada para la obtención de imágenes de largo alcance.
Para una percepción automatizada, la estabilización mejora la consistencia temporal y puede reducir el inicio de pistas falsas, las detecciones perdidas y la fatiga del operador. También ayuda a los algoritmos descendentes a utilizar señales de movimiento de forma más eficaz porque el movimiento de imagen causado por la plataforma se reduce antes de que se realice la detección y el seguimiento.
MSX - Imagen dinámica multiespectral
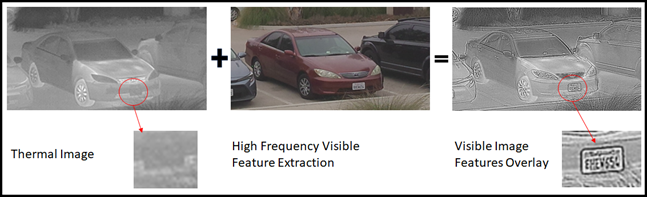
Figura 10 - MSX estampa los bordes visibles en imágenes térmicas en tiempo real
Hay muchos enfoques diferentes para la fusión de imágenes o la combinación de imágenes térmicas y visibles en una única secuencia de vídeo fusionada. El objetivo es sacar a relucir la información única y valiosa de cada espectro sin requerir la transmisión de dos o más flujos para que los operadores o sistemas humanos posteriores los analicen. Esto puede ser complejo en la práctica debido a la necesidad de un registro de imagen perfecto (alineación) de dos o más canales y problemas debido a los diferentes tiempos de integración para cada sensor.
El OEM de Teledyne FLIR ha patentado una tecnología única llamada MSX (imagen dinámica multiespectral). A diferencia de la combinación de imágenes (mezcla de una luz visible y una termografía), MSX no elimina los detalles térmicos ni reduce la transparencia térmica. En su lugar, aplica un filtro de alta frecuencia para extraer detalles visibles nítidos como simbología, incluidos contornos, palabras, números y otros detalles de borde de alto contraste, y los superpone en la imagen térmica. Esto ayuda a dar definición a la imagen y ha demostrado ser una tecnología beneficiosa en campos como el mantenimiento predictivo, la seguridad y las aplicaciones de ISR aéreas.
AGC – Control automático de ganancia
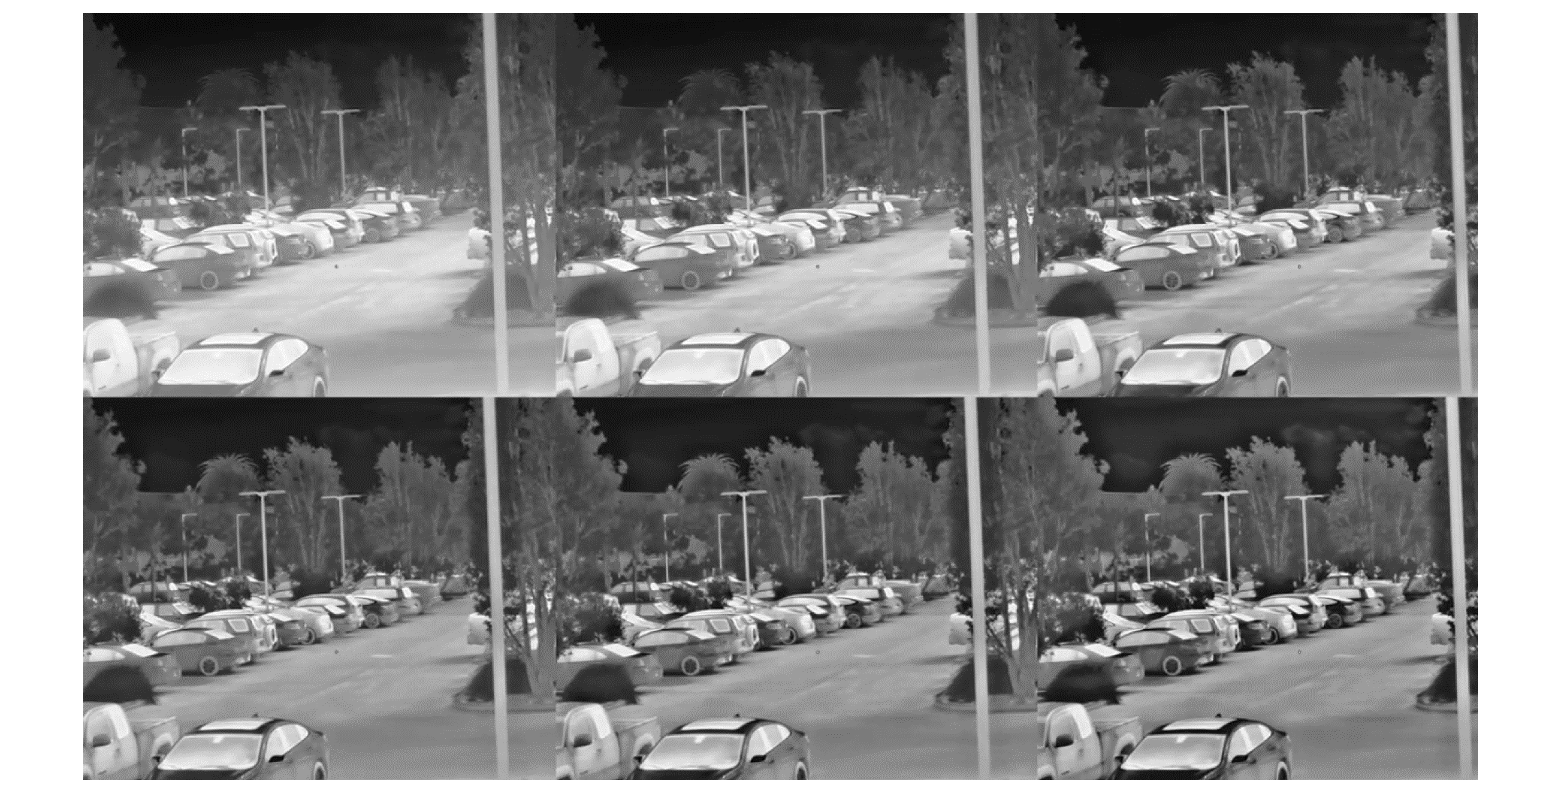
Figura 11 - Mejora del contraste local (vídeo fuente Boson® 640)
En el contexto de las imágenes, el contraste se refiere a la diferencia de intensidad entre las regiones más brillantes y más oscuras. Desempeña un papel crucial en la definición del impacto visual general de una imagen. La mejora del contraste local, también conocida como estiramiento del contraste local, opera sobre el principio de expandir el rango dinámico de contraste dentro de regiones específicas de una imagen en lugar de alterar globalmente el contraste de toda la imagen.
La mejora del contraste local resalta detalles complejos, mejora las texturas y acentúa las características. La conversión de los datos sin procesar del sensor monocromático de 16 bits en la profundidad de color de 8 bits que vemos en las pantallas se basa en algoritmos para mapear la amplia distribución de los valores de píxeles en 1 de 256 tonos de color o gris. Debido a que la distribución de valores de píxeles en una imagen rara vez es lineal, maximizar el contraste es muy complejo y dinámico de un escenario a otro. A diferencia de la mejora de contraste global, que ajusta el contraste en toda la imagen de forma uniforme, la mejora de contraste local se centra en preservar los detalles locales y las texturas finas. Se dirige a regiones más pequeñas dentro de la imagen y amplifica el contraste dentro de esas regiones mientras mantiene las relaciones de contraste relativas entre regiones vecinas.
Para las canalizaciones de IA, el mapeo de tonos y la mejora del contraste local deben gestionarse cuidadosamente porque dan forma a la entrada numérica al detector. Un ajuste que parece visualmente agradable no siempre maximiza la confianza del modelo, reduce las falsas alarmas o conserva los detalles de objetivos pequeños. El enfoque a nivel de canalización de Teledyne FLIR OEM permite evaluar estas opciones de procesamiento de imágenes con respecto a los objetivos finales del sistema de detección, seguimiento y asistencia para la toma de decisiones fiables dentro del sobre SWaP disponible.
10. Conclusión
Ha habido notables avances en aprendizaje profundo, procesadores integrados y herramientas de implementación de IA de producción. Para los sistemas térmicos y multiespectrales, estos avances son importantes, pero no son suficientes por sí solos. El mercado va más allá de la cuestión de si la IA puede funcionar en el perímetro. La pregunta más importante es si la canalización de percepción completa se puede diseñar para ofrecer información fiable y procesable sobre el terreno mientras se cumplen las exigentes restricciones SWaP, latencia, ancho de banda y térmicas.
La ventaja de Teledyne FLIR OEM va más allá de simplemente ejecutar IA en procesadores integrados. Es la capacidad de optimizar la canalización completa de percepción térmica de datos de sensores, procesamiento de señales de imagen, diseño de modelos, cuantificación, implementación en tiempo de ejecución, seguimiento, uso de memoria, gestión de energía y robustez ambiental como un sistema integrado. En aplicaciones prácticas en defensa, autonomía, robótica, automatización industrial, seguridad y sistemas automotrices, la diferenciación provendrá de esta integración completa en lugar de de la selección de modelos genéricos o TOPS principales.
Por lo tanto, la próxima generación de cámaras térmicas inteligentes se definirá por lo bien que se reúnen la física de detección, la imagen computacional, la IA integrada y la ingeniería de implementación. Al combinar la experiencia en sensores térmicos, Prism ISP, bibliotecas de detección y seguimiento específicas de aplicaciones y experiencia en la optimización de software en procesadores heterogéneos modernos, Teledyne FLIR OEM ayuda a los clientes a pasar de demostraciones de IA perimetral a sistemas de percepción implementados que funcionan en entornos operativos del mundo real.
[i] https://patentimages.storage.googleapis.com/f5/e3/05/021253fa9a6921/US20220019843A1.pdf
[ii] ¿https://patents.google.com/patent/US20220019843A1/en?oq=17 %2f374909
[iii] Una revisión de la inteligencia artificial en sistemas integrados https://doi.org/10.3390/mi14050897
Artículos relacionados
-
 Novedades
New Qualcomm-Built Advanced Video Processor by Teledyne FLIR Powers AI at the Edge
Lea la historia -
 Artículo
Simplify MWIR Development with Neutrino Featuring InVeo Electronics
Más información -
 Artículo
Comparing Sensitivity of Thermal Imaging Camera Modules
Más información